Login & Proof Points
Wähle deinen Tarif mit festem Punktekontingent und erhalte deinen Zugang zum Portal. Keine Mindestlaufzeit, Bezahlung per Rechnung möglich.
Portal-Login
 Termin buchen
Ein SEO-Crawler durchläuft eine Webseite wie eine Suchmaschine und deckt technische Probleme auf, bevor sie das Ranking kosten. Dieser Ratgeber erklärt, was ein SEO-Crawler ist, wie der Crawling-Prozess funktioniert, was ein Website-Crawler prüft, wie er für die SEO-Strategie wirkt und welche rechtlichen Grundlagen gelten.
Ein SEO-Crawler, auch Webcrawler, Website-Crawler oder Spider, ist ein Programm, das eine Webseite systematisch abruft, indem es von Seite zu Seite den internen Links folgt. Dabei protokolliert es zu jeder URL technische Merkmale und macht so den Zustand der ganzen Seite sichtbar.
Das Prinzip ist dasselbe, das Suchmaschinen nutzen: Der Crawler startet auf einer Startseite, liest den HTML-Code, findet alle Links, intern wie extern, und ruft diese Seiten ebenfalls ab, bis die gesamte Webseite durchsucht ist. Der Unterschied zum Googlebot: Ein SEO-Crawler arbeitet für dich und liefert dir einen auswertbaren Report.
Merksatz
Ein SEO-Crawler beschreibt nicht, ob Inhalte gut sind, sondern ob sie technisch erreichbar und sauber ausgezeichnet sind. Er prüft die Maschine hinter der Seite, nicht den Text darauf.
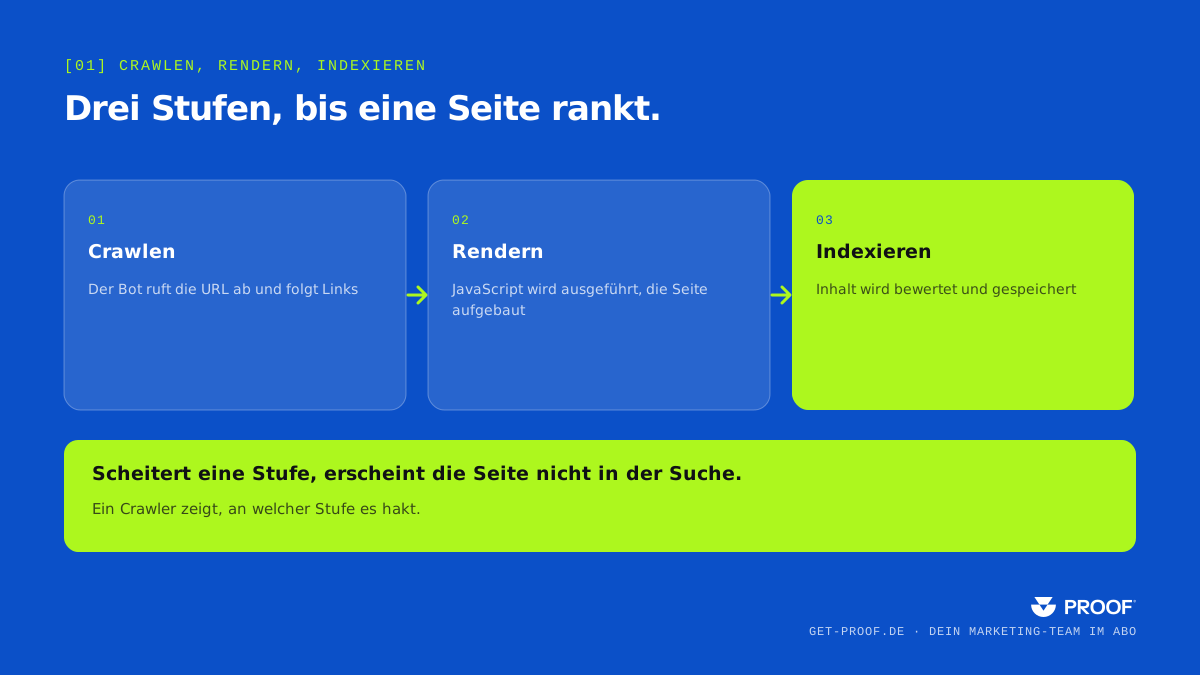
Hinter der Suche nach „crawling seo“ steht die Frage, wie Suchmaschinen eine Webseite überhaupt erfassen. Der Crawling-Prozess ist der erste von drei Schritten, mit denen Google Inhalte in den Index bringt:
Der Bot ruft Seiten ab und folgt ihren Links. Was er nicht erreichen kann, weil ein Link fehlt, eine robots.txt-Datei den Zugriff sperrt oder eine Seite zu tief in der URL-Struktur liegt, sieht er nicht.
Die Seite wird aufgebaut wie im Browser, inklusive JavaScript, um zu sehen, was ein Nutzer tatsächlich vorfindet. Dynamische Inhalte, die erst durch JavaScript geladen werden, können hier zum Problem werden, wenn der Bot sie nicht vollständig rendert.
Erst was gecrawlt und verstanden wurde, kann in den Index und damit in die Suchergebnisse gelangen.
Ein SEO-Crawler simuliert genau den ersten Schritt. Er zeigt, welche Seiten erreichbar sind, wo der Bot in Sackgassen läuft und wo Crawl-Budget an unwichtige URLs verschwendet wird.
Google crawlt nicht jede Webseite gleich oft. Die Crawl-Frequenz hängt von mehreren Faktoren ab:
Demo
In 30 Minuten zeigen wir dir das Board an deinem Thema und bringen einen Quick-Check deiner Domain mit. Kostenlos, ohne Verkaufsdruck.
Demo buchen30 Minuten · kostenlos · online
Eine häufig gestellte Frage, besonders im professionellen Online-Marketing: Darf man eine Webseite crawlen, die eigene wie die fremde?
Die eigene Webseite zu crawlen ist unproblematisch, genau dafür sind SEO-Crawler gemacht. Beim Crawlen fremder Webseiten gelten Regeln:
Für die Praxis heißt das: Die eigene Webseite regelmäßig crawlen ist nicht nur legal, sondern Teil jeder SEO-Strategie. Fremde Seiten nur mit Respekt vor robots.txt und angemessener Geschwindigkeit.
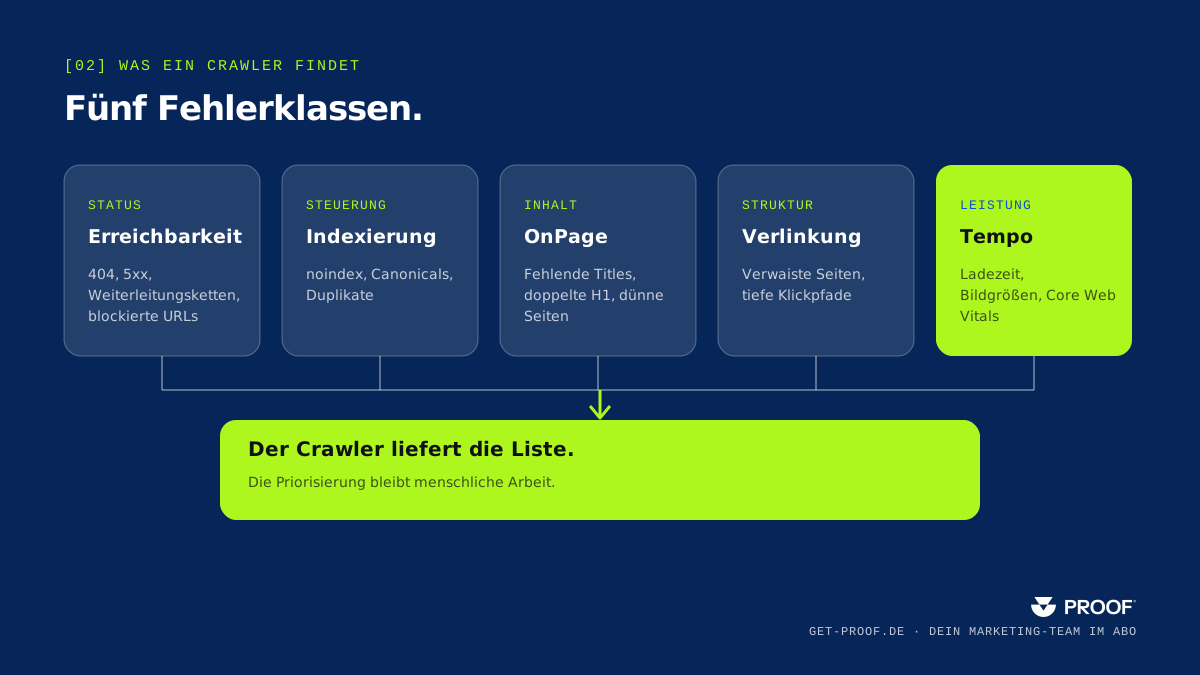
Ein SEO-Website-Crawler erfasst pro Seite Dutzende Signale. Sie lassen sich in drei Bereiche gruppieren: Der vollständige Crawl mit Bewertung und Maßnahmenliste ist Teil des SEO-Audit.
Statuscodes, defekte Links, Weiterleitungsketten, verwaiste Seiten und Crawl-Tiefe, alles, was den Bot am Durchkommen hindert. Eine saubere URL-Struktur und durchdachte interne Verlinkung sind hier entscheidend.
Title, Meta-Tags, Überschriften, Canonicals, doppelte Inhalte und fehlende Alt-Texte, die auszeichnende Ebene jeder Seite.
robots.txt-Datei, XML-Sitemap, Indexierbarkeit, Ladezeiten, Mobile-First-Indexierung, dynamische Inhalte und strukturierte Daten, die Regeln, nach denen gecrawlt und indexiert wird.
Erst zusammen ergeben diese Bereiche ein vollständiges Bild: Eine Seite kann perfekt ausgezeichnet und trotzdem unsichtbar sein, wenn der Crawler sie nicht erreicht, oder erreichbar, aber durch ein falsches robots-Signal von der Indexierung ausgeschlossen.
Aus SEO-Sicht ist der Crawler das Standardwerkzeug, um technische Probleme früh zu finden. Richtig eingesetzt, wirkt er an mehreren Stellen der SEO-Strategie:
Der Report zeigt, welche wichtigen Seiten der Bot nicht erreicht, verwaiste Seiten, Sackgassen, zu tiefe Klickpfade in der URL-Struktur.
Bei großen Webseiten verhindert er, dass der Bot Zeit an Dubletten, Parameter-URLs oder Endlosschleifen verliert. Bestimmte Seiten können über die robots.txt-Datei gezielt ausgeschlossen werden.
Fehlende Titel, doppelte Meta-Tags und kaputte Canonicals werden über die ganze Webseite auf einen Blick sichtbar.
Der Crawl zeigt, welche Seiten intern stark verlinkt sind und welche verwaist, die Grundlage, um Linkkraft gezielt zu verteilen.
Vor und nach einem Relaunch zeigt der Crawl, ob Weiterleitungen greifen und keine Seiten verloren gehen. Wie ein Umzug ohne Sichtbarkeitsverlust läuft, zeigt die Seite Website-Relaunch.
Häufiger Fehler: Jede Warnung wird gleich behandelt. Ein einzelnes fehlendes Alt-Attribut ist selten dringend, ein wichtiger Bereich, den der Crawler gar nicht erreicht, ist es sehr. Ohne Priorisierung ertrinkt das Wichtige im Rauschen.
Die Frage „welcher SEO-Crawler“ führt schnell zu einer langen Werkzeugliste. Grob lassen sich drei Typen von SEO-Software unterscheiden:
Wichtig unabhängig vom Werkzeug: Ein SEO-Crawler liefert Daten, keine Entscheidungen. Erst die Einordnung, welcher Fund wie schwer wiegt und in welcher Reihenfolge er behoben wird, macht aus dem Report echte Verbesserung.
Der eigentliche Nutzen eines Crawls liegt nicht im Finden, sondern im Beheben. Aus einem Report wird Wirkung, wenn er in einen Ablauf mündet: Technik-Fixes, interne Verlinkung und Monitoring übernimmt die SEO-Agentur als Aufgaben mit festem Preis. Wie die Befunde priorisiert werden, erklärt der Ratgeber SEO-Audit.
Wichtig bleibt: Ein Crawl muss zu Korrekturen führen, in einem festen Takt wiederholt und mit der Webseite mitgeführt werden.
Der Autor
Die ehrliche Einordnung
| Kriterium | PROOF | Selbst und manuell | Crawler-Tool allein | Klassische SEO-Agentur |
|---|---|---|---|---|
| Von Profis gemacht, nicht nur Vorlage oder Tool-Export | Ja | Nein | Nein | Ja |
| Fester Preis je Aufgabe, vorab sichtbar | Ja | Ja | Ja | Nein |
| Befunde interpretiert und priorisiert, nicht nur exportiert | Ja | Nein | Nein | Teilweise |
| Start in Minuten statt Angebotsrunde | Ja | Ja | Ja | Nein |
| Technik-Fixes direkt als Aufgaben beauftragbar | Ja | Nein | Nein | Teilweise |
| Keine Mindestlaufzeit, kein Retainer | Ja | Ja | Teilweise | Nein |
| Status jederzeit live im Board | Ja | Nein | Teilweise | Nein |
So läuft es mit PROOF
Vom Login bis zur ersten Aufgabe dauert es Minuten, nicht Wochen. Kein Onboarding-Workshop, kein Angebotsmarathon.
Wähle deinen Tarif mit festem Punktekontingent und erhalte deinen Zugang zum Portal. Keine Mindestlaufzeit, Bezahlung per Rechnung möglich.
Portal-Login
Du nennst uns deine Domain. Der Quick-Check zeigt Crawl-Fehler, Indexierungsprobleme und die größten technischen Hebel.
Quick-Check
Technik-Audit, Fehlerbehebung oder Monitoring: Jede Aufgabe hat einen festen Punktpreis. Proof Points werden reserviert und erst abgezogen, wenn du das Ergebnis abgenommen hast.
Katalog → Aufgabe
Fehler werden behoben, Crawl und Indexierung laufend überwacht. Status und Ergebnisse siehst du im Board und im Monatsreport.
Status im Board
Weiterführend
Die Leistungen, die Crawl-Befunde beheben.
Weiterlesen
Die nächsten Schritte: vergleichen, prüfen, planen.
SEO & Analyse
Ein SEO-Audit ist eine strukturierte Website-Analyse, die alle ranking-relevanten Bereiche prüft, Technik, OnPage, Content und OffPage, und die Befunde nach Wirkung priorisiert. Sein Wert entsteht nicht durch die Länge der Liste, sondern durch die Maßnahmen, die daraus folgen und zu besseren Rankings und mehr organischem Traffic führen.
SEO & Performance
Bilder-Optimierung bedeutet, Bilddateien so aufzubereiten, dass sie bei kleinstmöglicher Dateigröße gut aussehen und für Suchmaschinen lesbar sind. Sie hat zwei Seiten: die technische, Format, Komprimierung, Größe, und die der Bilder-SEO, Dateiname, Alt-Tag und Kontext. Ziel ist beides zugleich: optimale Ladezeit und Auffindbarkeit.
Technisches SEO & UX
Eine Breadcrumb-Navigation ist eine sekundäre Navigationshilfe, die den Pfad von der Startseite bis zur aktuellen Position als Spur anzeigt, etwa Start › Kategorie › Produkt. Sie verbessert die Orientierung der Nutzer und gibt Suchmaschinen ein klares Bild der Website-Struktur. Ihr Vorteil entsteht im Zusammenspiel mit einer sauberen Seitenstruktur.
Fragen
Du findest deine Frage nicht? Schreib uns direkt, wir antworten innerhalb eines Werktags.
hello@get-proof.deEin SEO-Crawler, auch Webcrawler oder Spider, ist ein Programm, das eine Webseite systematisch abruft, indem es von Seite zu Seite den internen Links folgt, so wie der Googlebot. Zu jeder URL protokolliert er technische Merkmale wie Statuscodes, Meta-Tags und Weiterleitungen und macht so den technischen Zustand der Seite sichtbar.
Crawling ist der Vorgang, bei dem eine Suchmaschine Seiten abruft und ihren Links folgt, um Inhalte zu entdecken. Es ist der erste von drei Schritten, Crawlen, Rendern, Indexieren, mit denen Google eine Seite in die Suchergebnisse bringt. Was nicht gecrawlt wird, kann nicht ranken.
Nein. ChatGPT selbst ist kein Webcrawler, sondern ein Sprachmodell, das auf Trainingsdaten antwortet. OpenAI betreibt allerdings einen eigenen Bot namens GPTBot, der Webseiten crawlt, um Trainingsdaten zu sammeln. Der Unterschied zu SEO-Crawlern: GPTBot sammelt Inhalte für KI-Training, ein SEO-Crawler analysiert die technische Struktur einer Webseite für die Suchmaschinenoptimierung. Über die robots.txt-Datei lässt sich der Zugriff von GPTBot gezielt per User-agent steuern.
WebCrawler war eine der ersten Internet-Suchmaschinen (gestartet 1994) und existiert heute als Meta-Suchmaschine. Sie hat nichts mit modernen SEO-Crawlern zu tun, der Begriff „Webcrawler“ wird im Online-Marketing allgemein für Programme verwendet, die Webseiten systematisch durchsuchen und analysieren.
Die eigene Webseite zu crawlen ist unproblematisch und Teil jeder SEO-Strategie. Beim Crawlen fremder Seiten gilt: Die robots.txt-Datei respektieren, keine übermäßige Serverlast erzeugen und gecrawlte Inhalte nicht ohne Erlaubnis vervielfältigen. Seriöse SEO-Software hält sich automatisch an diese Regeln.
Die Crawl-Frequenz hängt von mehreren Faktoren ab: Aktualisierungsrate der Webseite, Qualität der XML-Sitemap, Stärke der internen Verlinkung und externen Links sowie die Mobile-First-Indexierung. Häufig aktualisierte Seiten werden tendenziell öfter gecrawlt. Eine aktuelle XML-Sitemap und saubere interne Verlinkung sind die wichtigsten Hebel, um den Crawling-Prozess positiv zu beeinflussen.
Er erfasst pro Seite Erreichbarkeit (Statuscodes, defekte Links, Weiterleitungen, Crawl-Tiefe), Onpage-Signale (Title, Meta-Tags, Überschriften, Canonicals, Duplikate) und Steuerung (robots.txt-Datei, XML-Sitemap, Indexierbarkeit, Ladezeiten). Zusammen ergibt das ein vollständiges technisches Bild.
Beide arbeiten nach demselben Prinzip: Seiten abrufen und Links folgen. Der Googlebot crawlt für die Google-Suche und speist den Index. Ein SEO-Crawler crawlt für dich und liefert einen auswertbaren Report, um technische Probleme zu finden, bevor sie das Ranking beeinflussen.
Der nächste Schritt
In 30 Minuten zeigen wir dir das Board an deinem Thema, bringen einen Quick-Check deiner Domain mit und rechnen durch, welcher Tarif zu deinem Vorhaben passt.
 Lass dich von unserem Team beraten, unverbindlich und an deinem Thema.
Wähle Tag und Uhrzeit
30 Minuten · kostenlos · online
Termin wählenDer Kalender öffnet sich in einem Fenster und kommt von Calendly. Dabei werden Daten an Calendly LLC (USA) übertragen, Details in der Datenschutzerklärung.